AI 重塑企业工作流

AI Swaps the Executor First — Then Redesigns the Workflow, and the Organization

早上九点,我刚坐下,钉钉弹出一张卡片:你上周在群里答应过的事,今天到期,台账里还没关闭。卡片下面给了下一步:一键催办责任人。我愣了一下——这个承诺,我自己已经忘了。

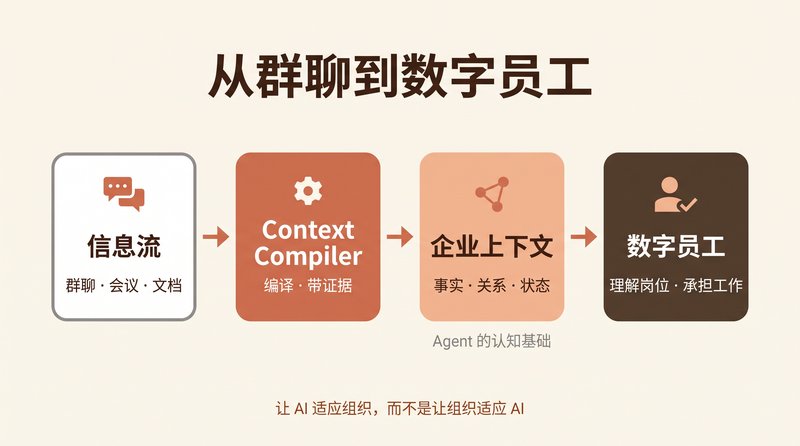
这样的早晨,过去几个月几乎天天发生。我一直在让数字员工接手我自己的工作流:每天读一千多条钉钉消息,编译事项台账,跟进我拍过的板、许过的诺(见从群聊到数字员工:AI 正在编译企业的影子工作系统)。以前这些靠我脑子记,漏掉的承诺就是漏掉的管理;现在台账替我记,到期它主动来提醒。

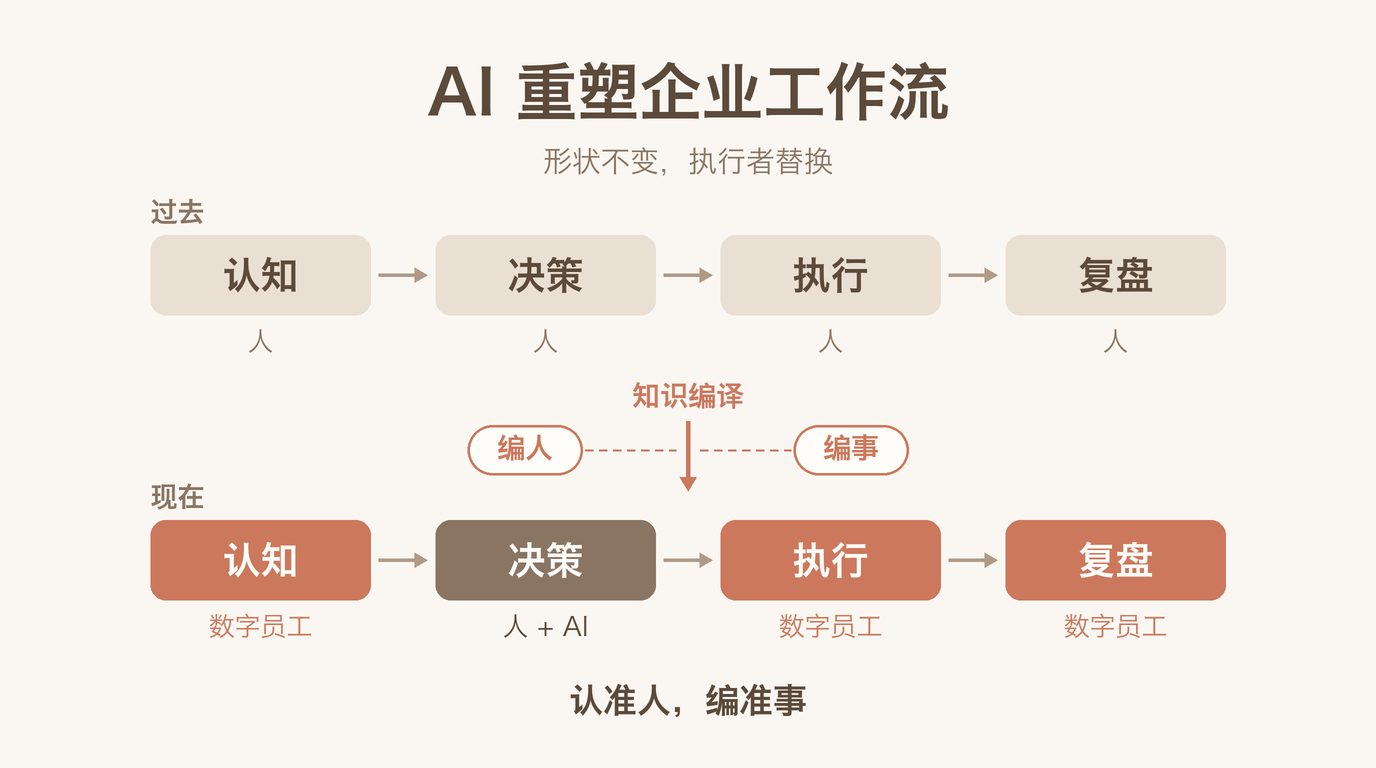
跑下来,体感分两层:第一眼,工作还是那个工作,变的只是每一步由谁来做;再往深看,有些步骤正在消失,也有些新步骤长了出来。把这份体感放大到企业视角,就是下面这篇分享。

AI Swaps the Executor First — Then Redesigns the Workflow, and the Organization

[Read More]

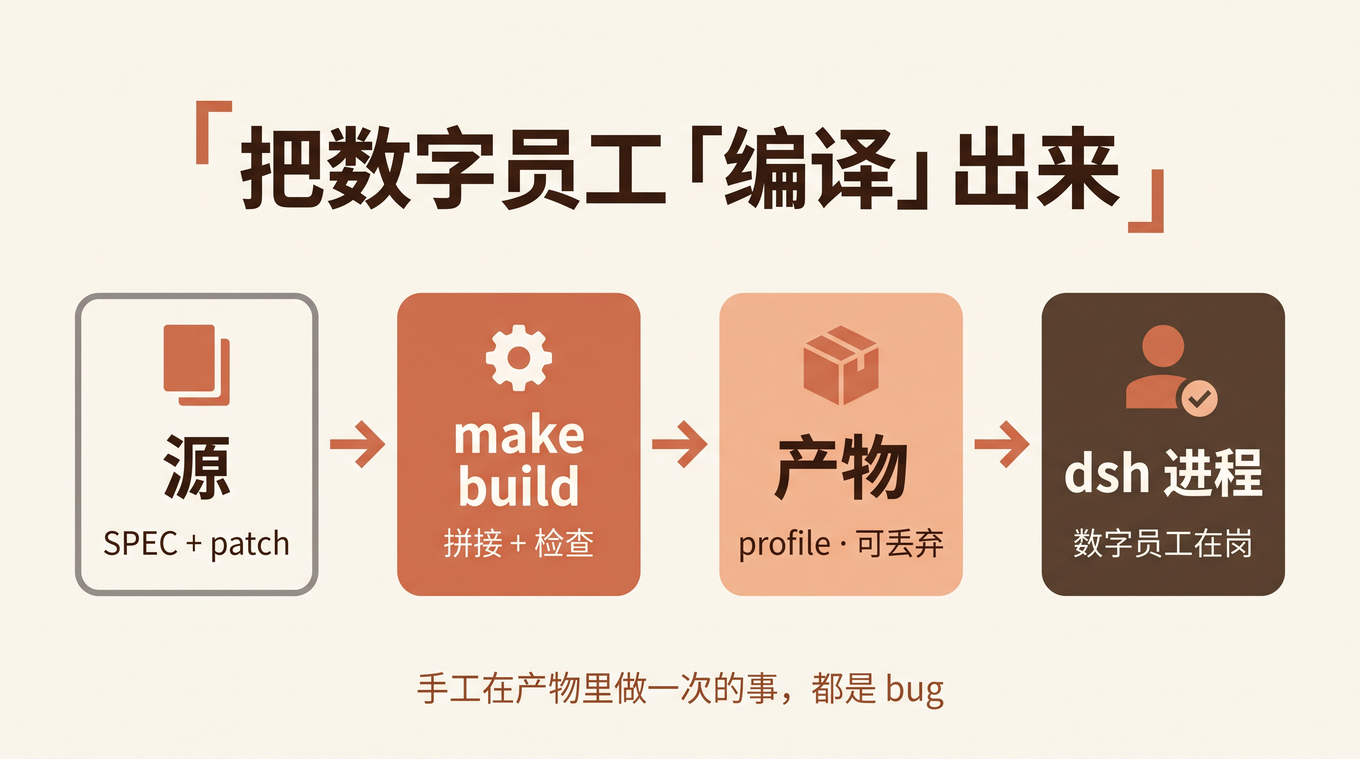
把数字员工「编译」出来:profile 组装里的静默坑

Compiling a Digital Employee: The Silent Traps of Profile Assembly

面向在 Agent harness 上做应用的工程师。你已经会写插件、调 persona。这篇讲一件更朴素的事:一个员工的定义,是怎么变成一个能跑的进程目录的 —— 以及这一步里那些「违反时不报错」的坑。

案例来自本仓库:跑在 DeepSeek Harness(dsh)上的钉钉数字员工。入口是 make build,实现在 bin/employee 的 build()。dsh 底座本身的理念与细节,见 DSH 微内核架构:数字员工的 To B 哲学 和 一切皆插件:DeepSeek Harness 真正硬核的是三个细节;本篇只讲组装的工程。

Compiling a Digital Employee: The Silent Traps of Profile Assembly

[Read More]

AI 能排什么,不能排什么

What AI May Rank — and What It Must Never Rank

前几天我手工做了一份研发效能排名,把一群工程师某两天的 PR 产出按质量和效率排了个序。做完之后,记住的是两件事。

第一件:评审记录里抓出一个极端案例——评审意见指出问题之后 54 秒,代码就合入了。这种事实只能靠把时间戳逐条比对出来。它躺在数据里,但没有任何模型会替你「读」出来。

第二件:这份排名差点在第一步就错了。GitHub 账号、IM 身份、群里的那个「人」,是三套账号体系。有个账号明明就是某位工程师,但证据只有群里几句「@某某 #PR 号」的交叉引用。如果我图省事直接猜合,就会把别人的产出算到他头上——这是这类系统能犯的最坏的错。

排名做出来之后我想明白了一件事:难点根本不在统计,在四件性质完全不同的事——认人、算数、取证、判断。而让 AI 做效能度量,成败取决于你有没有把这四件事分给不同的角色。

这篇把我此后一直遵守的通律写下来:AI 度量研发效能,精度分三层——事实高、判断中、因果低。 以及一个更反直觉的结论:排名只是副产品,真正的资产是它底下那层确定性事实——建好之后,一整张管理问题表都是近零边际成本白得的。

What AI May Rank — and What It Must Never Rank

[Read More]

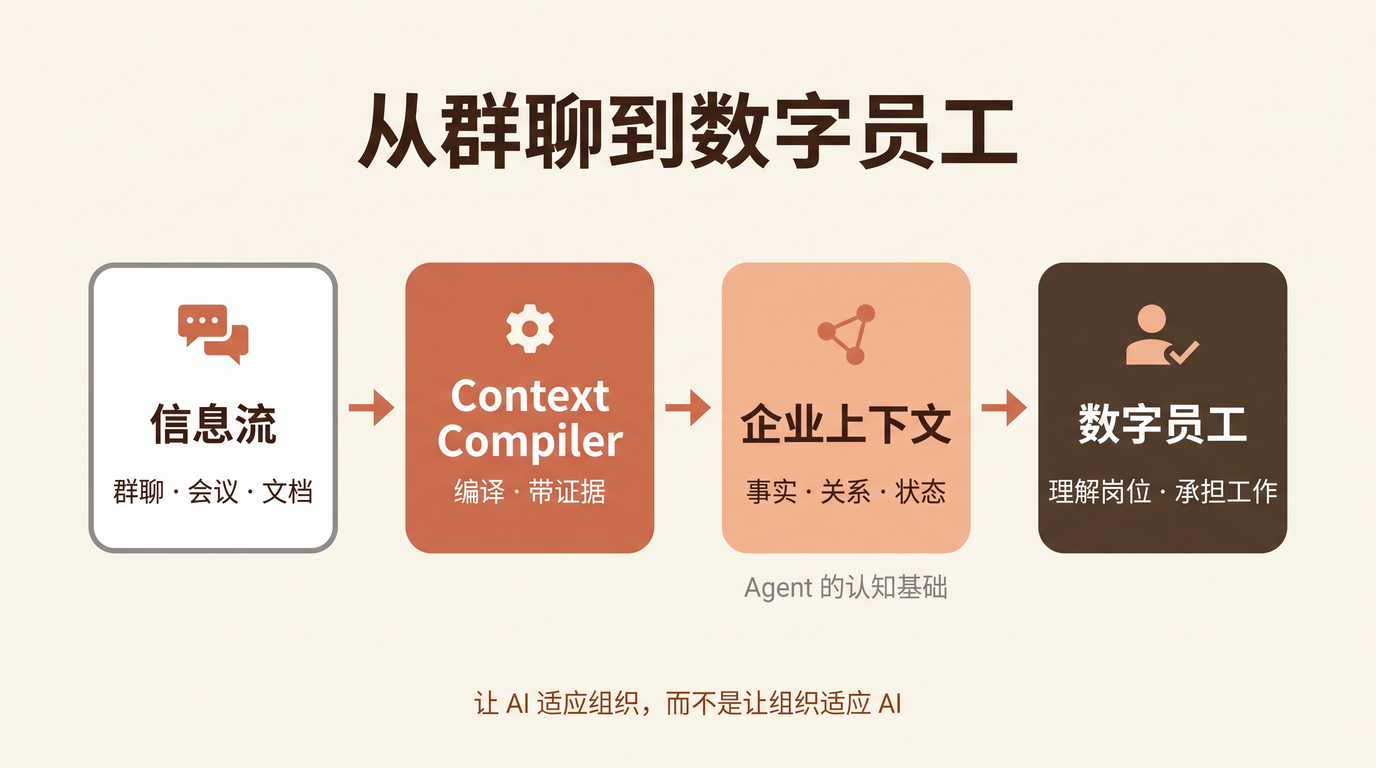
从群聊到数字员工:AI 正在编译企业的影子工作系统

From Group Chat to Digital Employee: AI Is Compiling the Enterprise's Shadow Work System

From Group Chat to Digital Employee: AI Is Compiling the Enterprise’s Shadow Work System

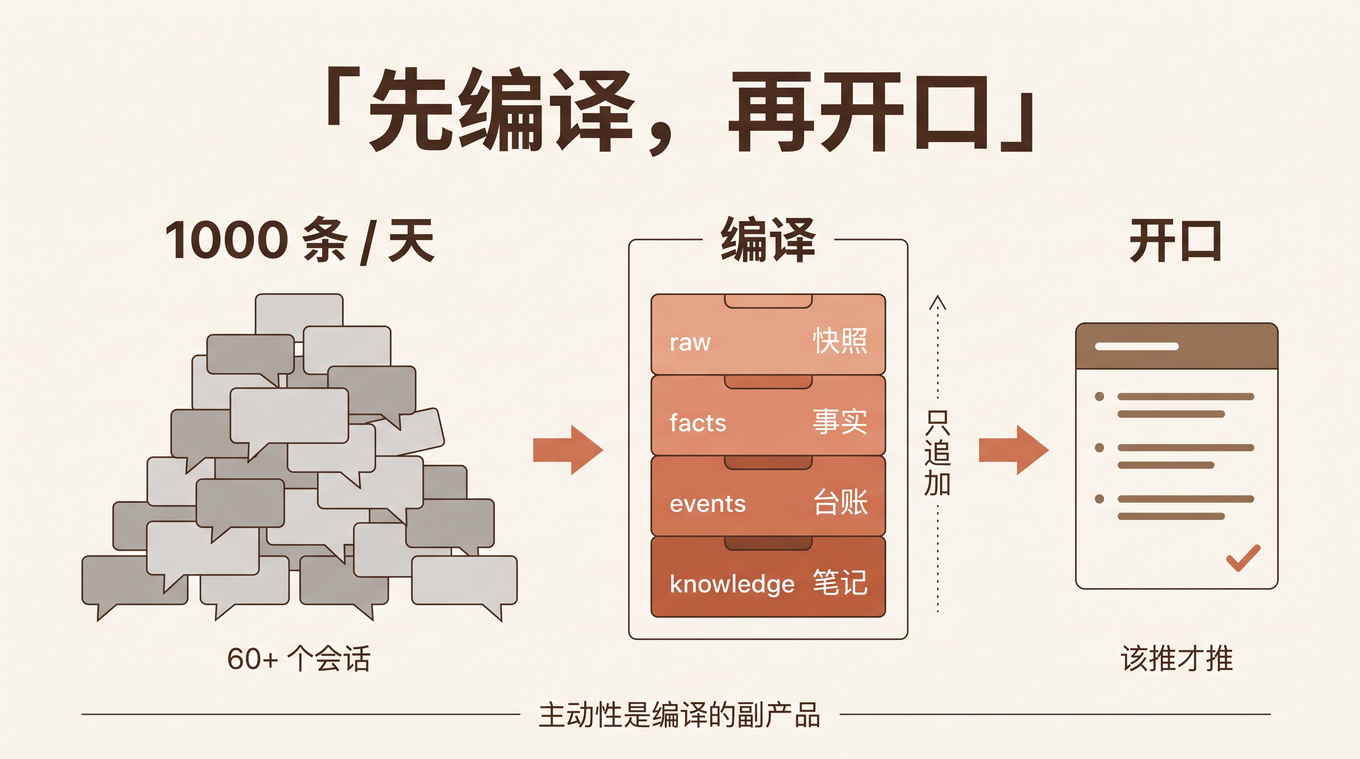
我先讲一个自己跑了一段时间的实验:让一个 Agent 每天读我的一千多条钉钉消息,先编译、再开口——我拍过什么板、许过什么诺、哪些事还没落地、哪些风险没人提醒我(详见每天 1000 条钉钉消息,我让一个 Agent 先编译再开口)。

这个实验让我确认了一件更朴素的事:这些真正推动我工作的东西,一直躺在聊天记录里,从来没有被任何正式系统替我记住过。

我个人的困境,放大几个数量级,就是企业的困境。

一、企业真正的工作系统,藏在影子里

每个企业都有一套正式的工作系统。

项目管理软件里有任务,CRM 里有客户,ERP 里有订单,OA 里有审批。它们共同构成了企业的信息化基础设施。

但如果仔细观察真实的工作过程,会发现一个有趣的现象:

真正推动企业运转的,往往不是这些正式系统,而是那些没有被正式记录下来的协作信息。

一个项目什么时候真正启动?可能是项目群里的一句「我们今天开始」。

一个任务什么时候被承诺?可能是某个人在群里回复「这个我来跟进」。

一个项目什么时候出现风险?可能是连续三天没人回复,或者负责人在会议中说了一句「这个事情可能要延期」。

一个决策什么时候发生?可能是老板在群里说了一句「就按这个方案执行」。

这些信息散落在群聊、单聊、会议、文档、邮件和各种业务系统中。

它们没有统一的数据结构,没有标准的状态机,也没有完整的生命周期管理。

但它们真实地决定着企业每天如何运转。

我们可以把这套系统称为企业的 影子工作系统(Shadow Work System)。

它不是一个软件,而是由人的沟通、承诺、决策、协作和执行共同构成的动态系统。

群聊就是其中最典型的载体。

二、传统企业软件的问题:要求人适应系统

过去二十年,企业数字化的基本思路是:

先定义业务流程,再设计软件系统,最后要求员工按照系统规定的方式工作。

这套方法非常有效,但也有明显的局限。

项目管理软件要求人主动创建任务、更新进度、维护状态;CRM 要求销售人员及时录入客户跟进记录;知识管理系统要求员工主动整理和沉淀知识。

这些工作本身并不创造业务价值,却成为使用系统的必要成本。

于是出现了一个普遍现象:

正式系统记录的是应该发生的事情,影子系统承载的才是真正发生的事情。

企业买了很多软件,却依然需要大量的人来追进度、催反馈、整理会议纪要、维护项目台账。

问题不是企业缺少软件,而是软件没有真正理解人的工作。

AI 带来了一个新的机会:

不再要求人把工作搬进系统,而是让 AI 进入人的工作现场,理解正在发生的事情,并自动构建工作系统。

这是一种根本性的范式变化。

[Read More]
群聊就是影子项目管理系统

The Group Chat Is the Shadow Project Management System

写给偏传统团队的项目管理者:没有 Jira、没有 Notion,或者买了但没人更新的那种。

The Group Chat Is the Shadow Project Management System

一、思考:为什么是「钉钉群 + AI 底层」

1.1 传统团队的真实项目管理系统,是群聊

偏传统团队的项目管理现状:没有 Jira、没有 Notion,或者买了但没人更新。真正承载项目的是钉钉群——重大讨论在群里、每日例会在群里、日报周报在群里、风险同步在群里、甚至口头承诺和拍板决策也在群里。

群聊是事实上的「影子项目管理系统」:信息全在里面,但是非结构化、易逝、依赖人脑记忆。产品机会不是再造一个系统让团队搬家,而是把这个影子系统编译成正式系统。

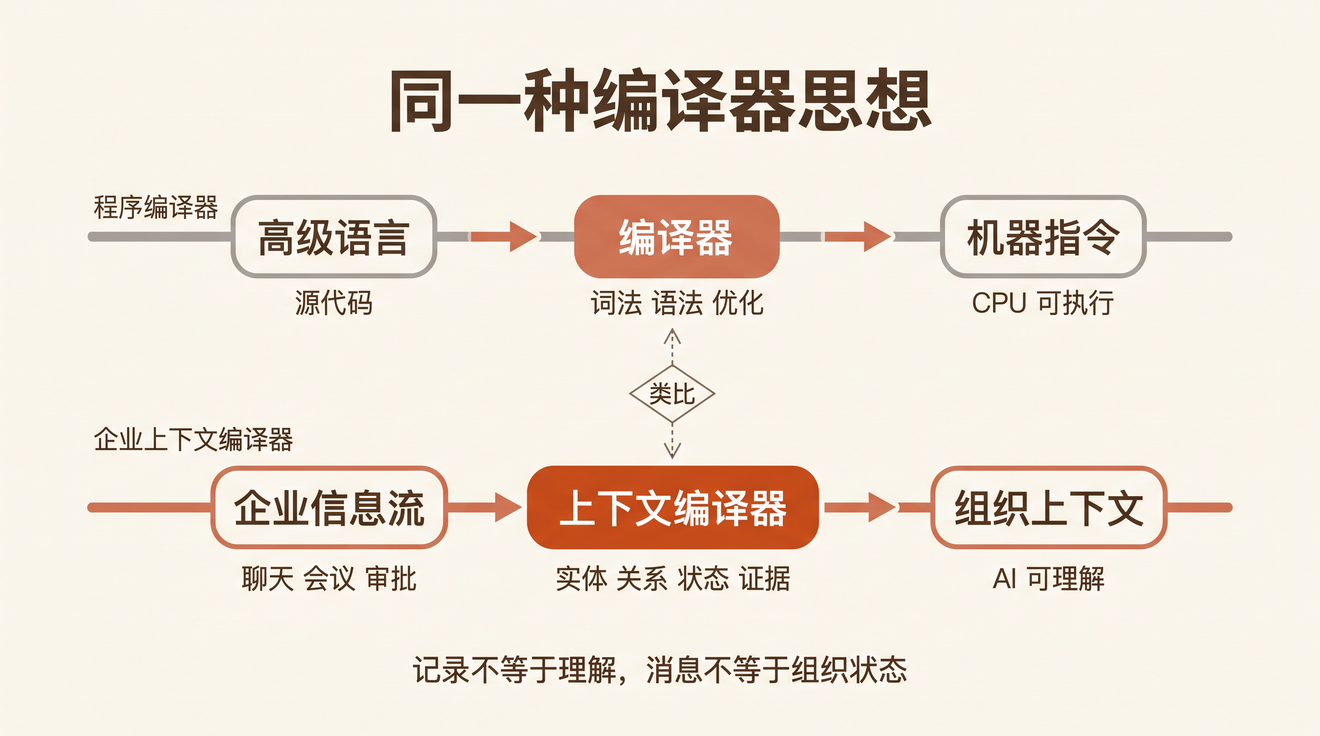
这正是 从程序编译器到企业上下文编译器 那条判断在一个具体场景里的落地:记录不等于理解,消息不等于组织状态——但消息可以被编译成组织状态。

1.2 传统项目的三大损耗

损耗表现代价
记忆损耗「上周拍板的事谁还记得?」「那个风险谁在跟?」决策重复讨论、承诺无人认领、风险靠人记忆
编译损耗PM 每天手工翻群拼日报、周会前突击汇总PM 80% 时间花在信息搬运,不是判断
响应损耗延期 3–5 天才被想起来上报风险发现永远滞后于风险发生

1.3 AI 原生工作流的定义:人不变,底层变

AI 原生 ≠ 让人学会用 AI 工具。

对传统团队,「原生」指的是工作流的产物机器可读、步骤 agent 可执行、闭环可自我迭代——而人留在自己的原生环境(群)里,习惯一点不改。

传统工作流:
人聊天 → 人记忆 → 人手工编译 → 人写日报 → 人追风险 → 人回答「那事怎么样了」

AI 原生工作流:
人聊天(不变)→ AI 编译(时间线/承诺台账/风险册)→ AI 召回(日报/预警/问答)
             → 人做判断(高质量输入 + 决策)→ 反馈回写,闭环迭代
# generated by hugo AI

我们的共识是:预配置数字员工可承接 80% 日常项目管理工作,人只负责提供高质量输入和线索。但有一个前提——agent 弥补不了人的不齐:团队没有 spec/规范共识,agent 也跑不顺。所以规范先行,不是工具先行。

[Read More]

知识编译最佳工程实践

Knowledge Compilation Engineering: Harness Plus Models

前阵子给工作助理 Muse 算账的时候,我发现一个很尴尬的数字:它每天写一篇工作日记,最早的做法是让模型带着工具自己去翻素材,一次要烧掉约 83 万 token,因为同一份上下文被来回重发了 9 次左右。改成「代码先把素材采齐、模型只调用一次」之后,降到约 6 万 token,耗时几乎不变。

省钱只是表面。更让我在意的是,第一种做法里模型每次都在 重新理解同一批原始消息:谁是谁、哪句话是承诺、哪件事已经关掉了。理解了一遍又扔掉,下次再来一遍,而且每次理解的结果还不完全一样。

这件事让我对知识编译(Knowledge Compilation)形成了一个明确的判断:

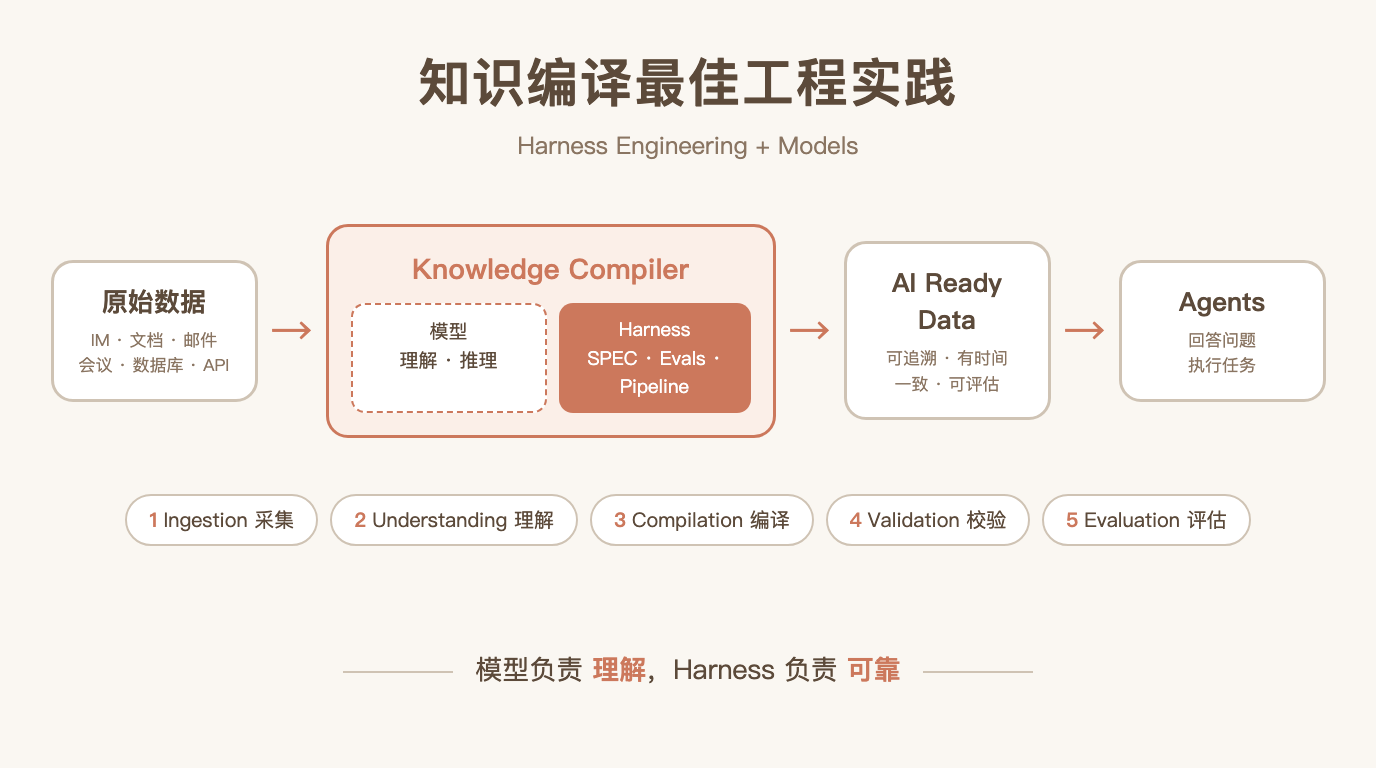
目前实现知识编译最合适的工程范式,是 Harness Engineering + Models。模型负责理解和推理,Harness 负责把理解和推理变成一个可靠、可持续运行、可评估、可迭代的工程系统。

这个边界很重要。只有模型,你得到的是一次次聪明但不可复现的理解;只有 Harness,你得到的是一套规则写死、碰到自然语言就失效的 ETL。两者分开各管一摊,知识编译才能成为一个工程系统。

我在 从程序编译器到企业上下文编译器 里讲了「企业上下文编译器」是什么:词法分析、符号表、IR、链接、增量编译怎么一一对上。这篇不重复那个类比,回答的是下一个问题:用什么工程范式把它造出来,以及怎样把它抽象成一套通用的知识编译架构。

Knowledge Compilation Engineering: Harness Plus Models

[Read More]

再谈 AI Native 工程:10 倍不是效率,是范式

10x Is Not an Efficiency Number, It Is a Paradigm Shift

写给已经在用 Coding Agent 写代码的工程师。

之前两篇文章(《用 SPEC 和 Evals 把数字员工做成一个能自我改进的系统》、《做好一个钉钉数字员工,只有三件事》)讲的是 单个系统怎么建:SPEC、Evals、基建。

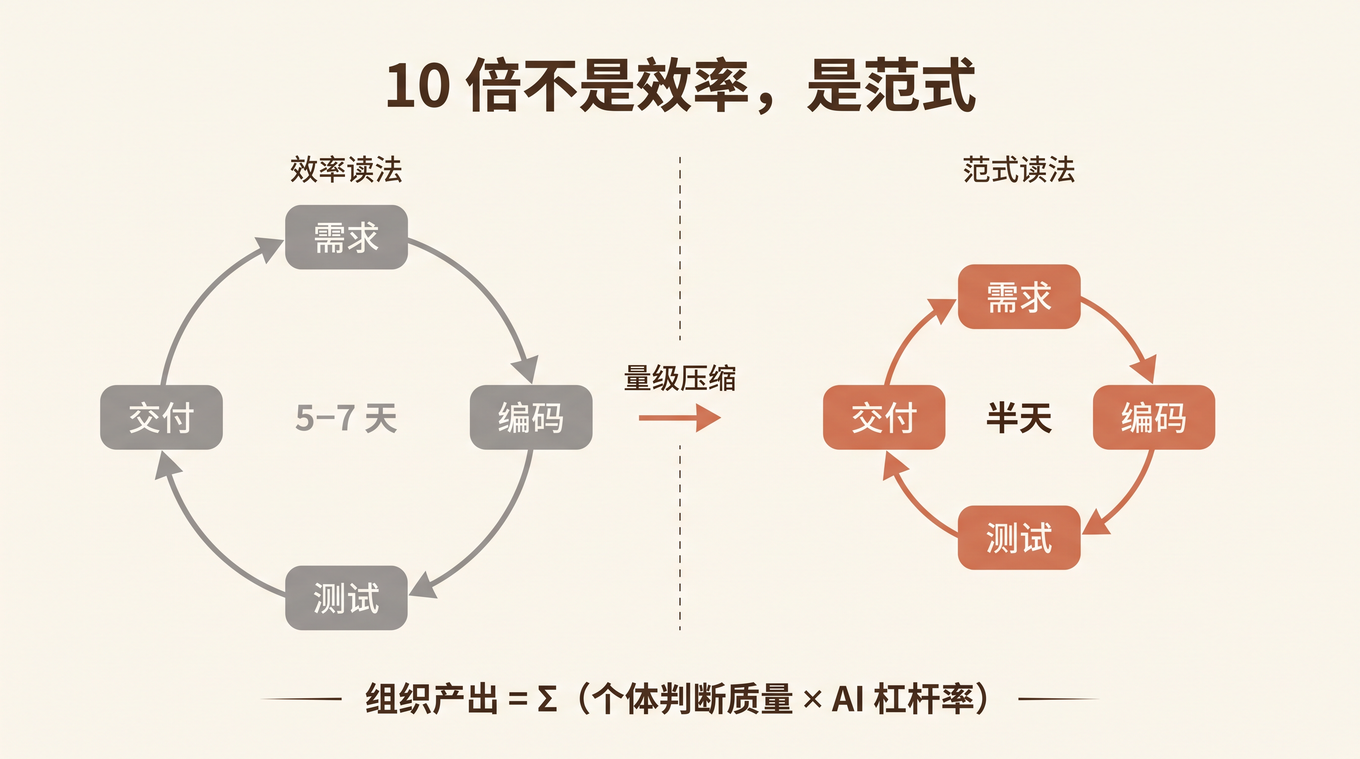
这篇往前站一层,谈整个研发组织:当 10 倍效率成为明确的战略要求时,瓶颈就从「怎么建系统」转移到了「组织里谁在建、怎么验收、怎么分配杠杆」。

先把结论放在前面:

10 倍不是让每个人写代码快 10 倍,而是把从需求到结果的闭环时间压缩一个量级。代码已经不稀缺,稀缺的是判断:定义什么是对的,证明交付确实是对的。一个研发组织 10 倍效率的上限,取决于它的判断密度,而不是程序员的数量。

下面五节,分别是这个结论在效率、环境、测试、人才和知识沉淀上的推论。

10x Is Not an Efficiency Number, It Is a Paradigm Shift

[Read More]

从程序编译器到企业上下文编译器

From Program Compiler to Enterprise Context Compiler

昨天那篇 每天 1000 条钉钉消息,我让一个 Agent 先编译再开口 是从一个 ❌ 开始的:我在单聊里问一位同事某件事要不要先做,他回了四个字「今天弄好」;5 分钟后,我的工作助理 Muse 把这句话当成急事推给了我——而我 7 分钟前就在和他聊这件事。

那次修的是推送时机。但这四个字之后一直在我脑子里,因为它暴露了另一个问题:同一件事,在我的台账里是「等别人交付」,在他那边是「我要办」。 Muse 只编译了我这一半。他那一半在他脑子里、在他的待办里,或者哪儿都没有。

把一个人的工作流编译成 AI 能用的上下文,444 那篇已经跑通了。这篇往上走一层:一个组织的工作流,能不能像程序一样,被一台编译器编成 AI 可以执行的上下文?

我的回答是能,但前提是把「编译器」这个类比当真——不是借个名字,而是把词法分析、符号表、中间表示、链接、增量编译一一对上,再老实承认它在哪里不成立。恰恰是不成立的那几处,决定了这台编译器该怎么设计。

From Program Compiler to Enterprise Context Compiler

[Read More]

每天 1000 条钉钉消息,我让一个 Agent 先编译再开口

Compile Your Work Stream Before Your Agent Speaks

前几天,我对自己的工作助理打了一个 ❌。

它推过来一张「工作事项提醒」:🔴 等别人交付——某同事今天要把一件事弄好。问题是,这件事我 7 分钟前还在和那位同事单聊。我问他要不要先做,他回「今天弄好」,助理把这句话记进了台账,5 分钟后就把它当成急事推给了我。截止时间是当晚。

信息本身没错,每个字都对得上原话。错在 时机:我正在处理的事,它又来提醒我一遍。这一个 ❌ 让我意识到,我给这个助理(下文叫它 Muse)定的目标——「主动帮我管理钉钉上的工作信息流」——难点从来不在「主动」,而在主动之前那一步:它得先知道哪件事是谁的、现在是什么状态、我此刻在干什么。

这三件事,靠一个更聪明的模型现场去翻聊天记录是翻不出来的。它们得被 编译 出来。

Compile Your Work Stream Before Your Agent Speaks

[Read More]

过去只有富人和大公司买得起的服务,正在变成默认配置

Services Only the Rich and Big Companies Could Buy Are Becoming the Default

曾鸣第三次「看十年」公开课的整理稿今天上午刚发出来——笔记侠整理,两万多字,讲的是他在杭州湖畔创研中心那场演讲。他开场第一句不是讲趋势,是讲自己的状态:

我这两个月越来越不焦虑了,因为很多东西越看越清楚。

这句话让我停了一下。过去两年 AI 圈的主流情绪恰恰相反——所有人都在焦虑:模型会不会又换代、投入那么大为什么效果不好、拐点到底在哪。而曾鸣是阿里巴巴集团前总参谋长、两次被 Thinkers50 评为全球最具影响力的战略思想家,他的「不焦虑」不是安慰,是一个判断:AI 刚进入第二阶段的开场,应用大爆发还没真正开始,浏览器还没有出现,所有人都在同一条起跑线上。

这场演讲被拆成六个命题(智能商业、AI 原生、产业化阶段、价值创造、创智组织、智能战略),两万多字。但对我最有冲击的只有一个论断,它藏在第一节,篇幅不长,却把我这两年一直在做、却说不清的事一句话说穿了:

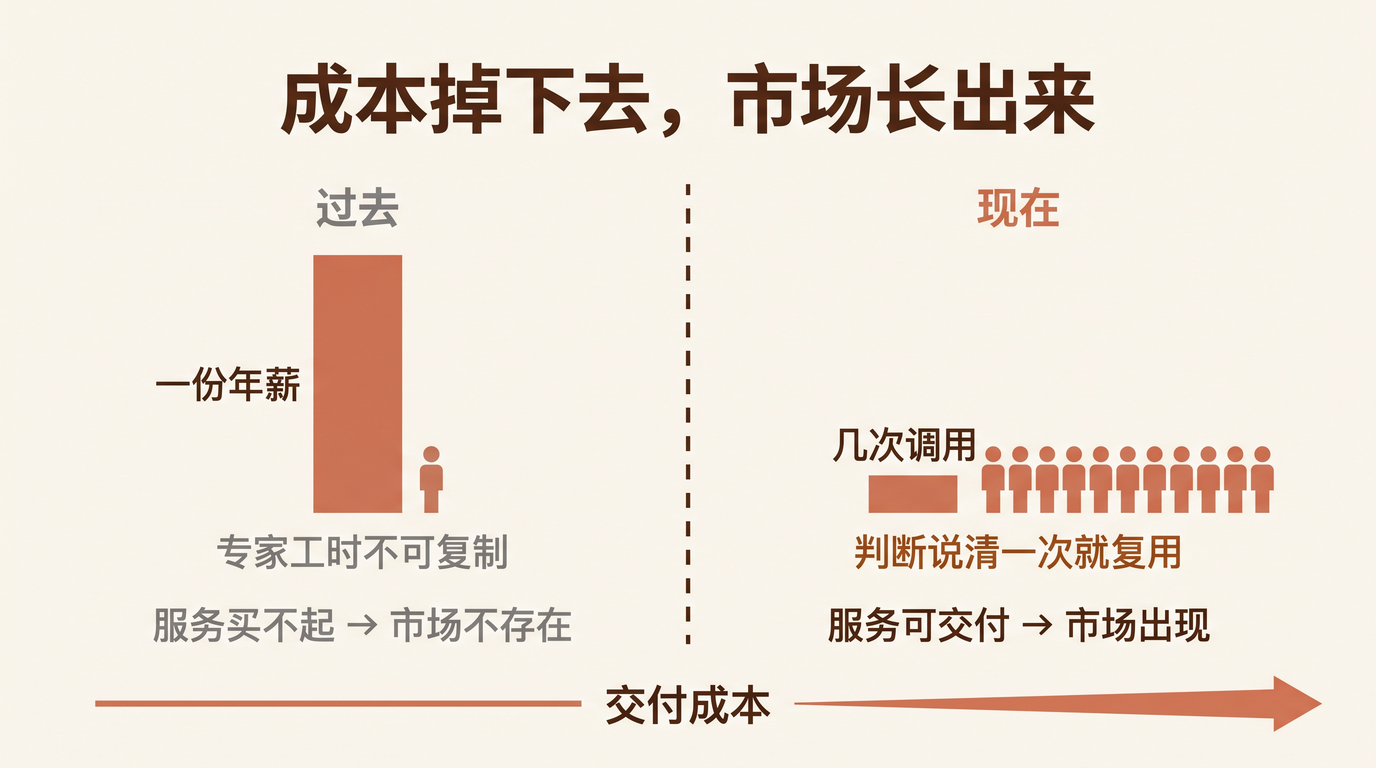
真正创造巨大价值的是打开新的供给。好的私人医生、好的老师、好的理财顾问,旅游时能给你真正建议的可信的信息专家,任何一个方面我们都觉得好的供给太少、太稀缺。

不是把现有服务做得更快更便宜,是 让一批过去根本不存在的市场出现。而它之所以现在可能,是因为 AI 把满足每个人具体需求的交付成本打到了极低——低到过去只有富人和大公司买得起的东西,正在变成默认配置。

Services Only the Rich and Big Companies Could Buy Are Becoming the Default

[Read More]