本地跑大模型这件事,门槛从来不是模型——Qwen3-4B 的权重谁都能下。门槛是那块能把 4B 模型跑到「可用」的芯片,以及为它付的几百上千美金和几十瓦电费。
我花 299 美金买了一块 Arduino VENTUNO Q,把这件事的门槛砸到了地板上:一块 160×100mm 的开发板,NPU 上跑 Qwen3-4B 文本 16.6 tok/s、跑 Qwen3-VL-4B 看图 13 tok/s,纯本地、零边际成本、常驻不关机。
开始教程之前,先把一件事说清楚:这篇文章的所有配置,都是用 OpenCode 以对话方式完成的,没有一行命令是我手敲的,效率比手工高得多。 OpenCode 作为 agent 直接在板子上执行 shell、读写文件,背后配 DeepSeek V4 Flash(快、便宜、上下文长),查资料、装环境、部署模型、写服务、排错,甚至板子上那份上手文档的初稿,全部在一个会话里贯通。这种做法的效率提升非常直接:不用手工复制命令,不用在搜索引擎和终端之间来回切换,agent 踩了坑当场修,下文的每一条命令都是它当时实际执行、验证通过的记录。最后配出来的本地 VLM 服务本身就是一个 OpenAI 兼容后端,又反过来接进 OpenCode 用——用 AI 搭 AI,闭环了。
这篇是完整上手教程——从开箱到把它变成一个 OpenAI 兼容的常驻服务,接进你的 Agent 工具链。中间有三个能让你白耗一个下午的坑,我一并写清楚。
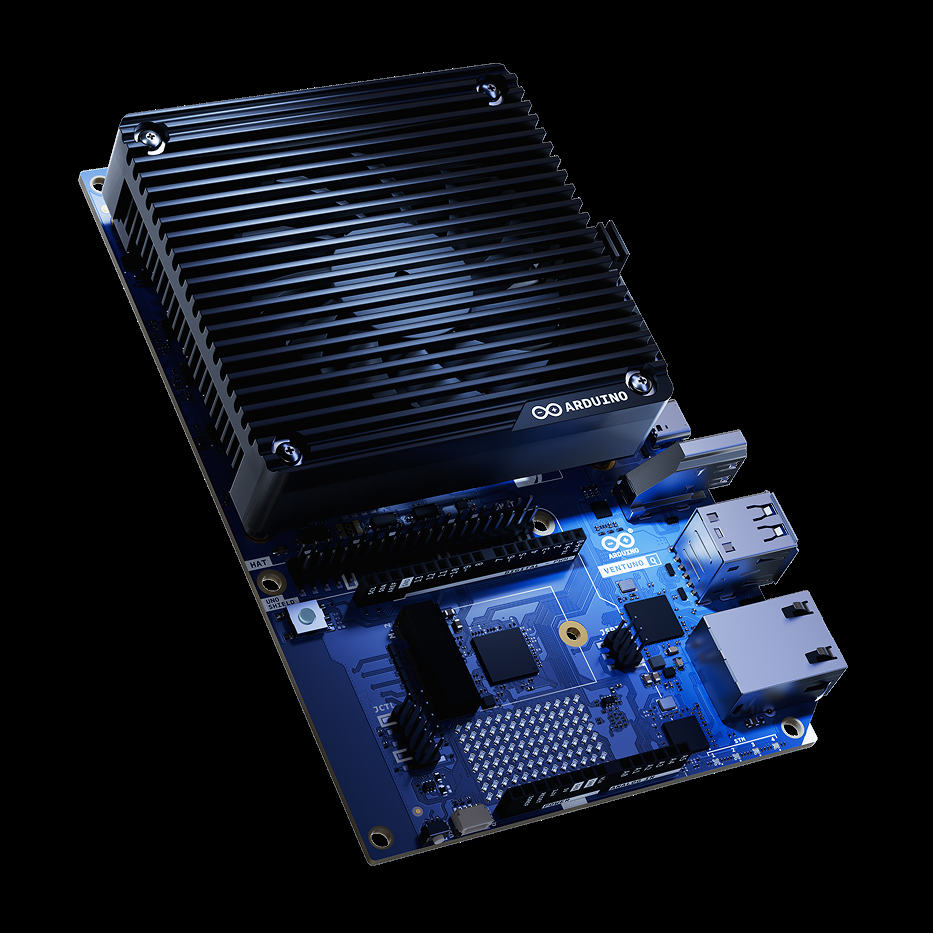
Arduino VENTUNO Q 官方产品图(仅作描述性引用)
一、这是什么板
一句话:它是一台完整的 Ubuntu 电脑,只是长成了开发板的样子,还多了一颗专门跑 AI 的 NPU。
VENTUNO Q 用的是「双脑架构」——一颗 Qualcomm 处理器管 AI 推理,一颗 STM32 单片机管实时控制,两者通过 RPC 桥接。对做本地知识库的人来说,只有前一颗脑重要:
| 部件 | 规格 |
|---|---|
| AI 脑(MPU) | Qualcomm Dragonwing IQ8(IQ-8275),8 核 Kryo CPU、Adreno 623 GPU、Hexagon NPU(40 dense TOPS) |
| 实时脑(MCU) | STM32H5F5,Cortex-M33 @ 250MHz,跑 Zephyr RTOS |
| 内存 | 16 GB LPDDR5(NPU/CPU/GPU 共享) |
| 存储 | 64 GB eMMC,M.2 插槽可扩展 NVMe(PCIe Gen.4) |
| 网络 | 三频 Wi-Fi 6、蓝牙 5.3、1× 2.5GbE 网口 |
| 系统 | Ubuntu 24.04.5 LTS,内核 6.8.0-qcom |
价格:官方 US store 预售价 299 美金(SKU ABX00181,2026-08-25 开订,含一个 65W USB-C 电源,约 4 周发货)。这是「introductory price」,预售结束后大概率上调——想入的话别等。
到手 SSH 进去,它就是一个主机名叫 ventunoq、用户叫 arduino 的普通 ARM64 Linux 主机。你可以像用任何一台服务器一样用它:Docker、Python、venv、systemd,全都在。这一点很关键——它不是玩具单片机,是能常驻跑服务的小电脑。
二、30 分钟把模型跑起来
本地推理跑在 Hexagon NPU 上,运行时是 Qualcomm 的 GenieX。下面是从零到跑通的全过程。
先修一个必踩的依赖坑
精简镜像常缺 libatomic.so.1,首次加载模型会报 libatomic.so.1: cannot open shared object file 或 Qnn getQnnSystemInterface FAILED。不用 sudo 的修法:
cd /tmp
apt-get download libatomic1
dpkg-deb -x libatomic1_*.deb libatomic-extract
PREFIX="$HOME/.local/share/geniex"
cp -f libatomic-extract/usr/lib/aarch64-linux-gnu/libatomic.so.1.2.0 "$PREFIX/"
ln -sf libatomic.so.1.2.0 "$PREFIX/libatomic.so.1"
GenieX 的启动 wrapper 已经把 $PREFIX 加进了 LD_LIBRARY_PATH,放进去就生效。
拉模型、跑推理
推荐用 AI Hub 的预编译包(全程走 NPU,不用自己选量化,也不依赖被墙的 Hugging Face):
geniex pull qualcomm/Qwen3-4B-Instruct-2507
geniex infer qualcomm/Qwen3-4B-Instruct-2507
首次 infer 会问你 Model type(文本选 llm)和 Precision(量化选 Q4_0)。我这个 shell 没有 TTY,所以用 -p 做单轮提问;真正的多轮 REPL 要在真实终端里跑 geniex infer <model>:
geniex infer local/qwen3-4b-instruct-2507 -p "你好"
下载慢的解法:
geniex pull直连 Qualcomm S3 只有约 65 KB/s,而且 GenieX 不读HTTPS_PROXY环境变量。大 bundle(Qwen3-4B 约 2.36 GB)建议用 curl 走代理下好,再本地注册:curl --proxy socks5h://<你的代理>:11081 -C - -o qwen3.zip "<bundle URL>" geniex pull local/qwen3-4b-instruct-2507 --local-path qwen3.zip --model-type llm协议写
socks5h(带 h)时 DNS 也走代理,更稳。Hugging Face 直连不通的话,export HF_ENDPOINT=https://hf-mirror.com或用 ModelScope。
视觉模型同理
geniex pull qualcomm/Qwen3-VL-4B-Instruct     # AI Hub 预编译 QAIRT 包,约 2.83 GB
geniex infer local/qwen3-vl-4b-instruct \
  -p "详细描述这张图片,并识别其中的文字。Image: /home/arduino/test.jpg"
图片用 绝对路径 写在 prompt 里,.jpg/.jpeg/.png/.webp 会被自动识别。Qwen3-VL 本质是「语言模型 + 视觉编码器」,纯文本也能用;但只做文本时,专用的 qwen3-4b-instruct-2507 更省资源、更快。
实测性能
我这块板上的真实数字(w4a16 量化,全程 NPU):
| 模型 | 任务 | 速度 | 首 token |
|---|---|---|---|
| Qwen3-4B(文本) | 单轮 93 token | 16.6 tok/s | 0.1 s |
| Qwen3-VL-4B(视觉) | 描述 1024×683 图,105 token | 13.0 tok/s | 0.6 s |
对照官方基准(Qwen2.5-1.5B):GenieX+NPU 约 25 tok/s,llama.cpp+Adreno GPU 7.4 tok/s,Ollama+CPU 5.3 tok/s。结论很直接:要加速就用 GenieX + NPU,Ollama 在这块板上只能跑 CPU,别用。 想自己测就跑官方工具 geniex-bench -m <model> --device npu -n 128。
三、把它变成常驻服务
跑通 infer 只是玩具。真正的价值是让它变成一个别人能调的 OpenAI 兼容后端。链路是这样:
你的 Agent(OpenCode / 任意客户端)
        │  OpenAI API
        ▼
LiteLLM 网关(另一台机器,:4000)
        │  api_base = http://<tailscale 名>:8080/v1
        ▼   (tailscale 把 8080 暴露进 tailnet)
vlm_server.py(本机 0.0.0.0:8080)
        │  守护进程 + 远程图片转 base64 + 模型别名 + 鉴权
        ▼
geniex serve(本机 127.0.0.1:18181,Hexagon NPU)
# generated by hugo AI
最底层一行命令就够:
geniex serve # 起一个 OpenAI 兼容服务,监听 http://127.0.0.1:18181/v1
任何 OpenAI 客户端把 base_url 指过去就能用。我在它前面套了一层 vlm_server.py(纯标准库写的)补三件事:守护 geniex serve(挂掉自动重启)、把消息里 http(s) 的图片 URL 自动下载转 base64(GenieX 只吃 base64 或本地路径)、加模型别名和可选 Bearer 鉴权。用 systemd 常驻:
cd ~/Projects/qwen-server
./ctl.sh install-service     # 复制单元 + systemctl --user enable --now vlm-server
再通过 tailscale 把端口暴露到内网(我的 tailscale 跑在容器里):
docker exec tailscale-hugo tailscale serve --bg --tcp=8080 tcp://host.docker.internal:8080
暴露后,网关机器就能用 http://<tailscale 主机名>:8080/v1 访问。网关侧我挂的是 LiteLLM,客户端用别名 qwen3-vl-4b / qwen3-4b 引用即可。
接进 OpenCode(一个必须写对的字段)
在 OpenCode 的全局配置里加一个 OpenAI 兼容 provider:
{
  "providers": {
    "local": {
      "name": "Local",
      "package": "@opencode/ai/providers/openai-compatible",
      "settings": { "baseURL": "http://<网关>:4000/v1", "apiKey": "***" },
      "models": {
        "qwen3-vl-4b": {
          "capabilities": { "tools": false, "input": ["text", "image"], "output": ["text"] },
          "limit": { "context": 8192, "output": 2048 }
        }
      }
    }
  }
}
"tools": false 这个字段不写,会话会直接卡死。 原因见下一节。
四、三个会让你白耗一下午的坑
教程写到这里,最有价值的部分才开始——不是「怎么跑通」,是「哪里会让你跑不通」。
坑一:不要升级到 Ubuntu 26.04,会把板子搞成砖。
SSH 进去,do-release-upgrade 会热情地提示你有 26.04.1 LTS 可升。别升。这是 Ubuntu 通用版本列表的锅,它不知道你这台是带厂商 BSP 的 VENTUNO Q。Arduino 官方在论坛里已经确认这是 bug,原话:
「After further testing we determined that there are incompatibilities between Ubuntu 26.04 and the VENTUNO Q. The update offer is the result of a bug. If you have installed the update, please reflash the operating system to revert back to the officially supported Ubuntu 24.04.」
升级后你会遇到:串口消失(Arduino IDE 串口监视器失效)、adb shell 进去变成 root 而不是 arduino(定制版 adbd 被上游版顶掉了)。想启用适配 26.04 的新内核 PPA?大概率 开不了机。而这板子是 UEFI + GRUB + eMMC、没有 A/B 分区回滚——起不来的唯一出路是重刷 eMMC 镜像,数据全丢。
24.04 是 LTS,标准支持到 2029 年,你没有任何理由现在升。顺手把升级提示关掉,免得哪天手滑:
sudo sed -i 's/^Prompt=.*/Prompt=never/' /etc/update-manager/release-upgrades
(24.04 内部普通的 apt upgrade 安全更新照跑,没问题。)
坑二:GenieX 不读代理,也不支持工具调用。
两件事叠在一起,专门坑想把它当 coding agent 用的人:
- 不读代理:
geniex pull无视HTTPS_PROXY/ALL_PROXY,所以大模型只能像第二节那样 curl 走代理下好再本地注册。 - NPU 运行时不支持 tool / function calling:GenieX 的
qairt(NPU)运行时压根没有工具调用能力。这就是为什么 OpenCode 配置里必须写"tools": false——不写,OpenCode 默认假设自定义模型支持工具,发过去一个 tool call,模型不响应,会话就卡住或退化。结论:这两个本地模型只能当对话 / 看图用,当不了需要读写文件、执行命令的 coding agent。 想让 Agent 干活,还得走云端的强模型。
坑三:NPU 包的上下文是编译时固定的。
别在客户端把 context 写成 1000000。NPU 预编译包的上下文窗口在编译时就定死了(约 4–8k),geniex infer 的 --nctx 对它无效。老老实实写 8192。
五、它到底是不是「个人知识库开发板」
回到标题。我为什么叫它个人知识库开发板,而不是「便宜的开发板」?
因为它精确填上了一个一直缺位的东西:一台够便宜、够省电、能常驻的本地 AI 节点。 我在 我的知识编译器,把自己的源代码编译没了 里写过,一个个人知识系统的核心是把非结构化世界持续编译成 Agent 能用的 Context,而这套编译管线的「Local First, Cloud When Needed」原则一直缺一个落地的硬件——你不会为了跑个 OCR、分类、实体抽取,专门开一台带 A100 的云主机。
这块板补上了那个位置。它的 NPU 恰好擅长那些 确定性、高频、不需要顶级智能 的活儿:给 inbox 里的图片做 OCR、给文档分类、抽取实体和 claim、做去重判断。这些是知识编译管线里 CPU 之上、云端之下的那一层——16 tok/s 不够写论文,但足够在你睡觉时把当天 inbox 里的素材全部预处理一遍。复杂的长文推理和最终决策,再交给云端强模型。
这才是 299 美金真正的意义:它买不到一块 GPU,也替代不了云端旗舰模型。它买到的是一个 永远在线、数据不出门、边际成本为零 的本地节点。对个人知识库来说,这恰好是最缺、也最难用云补的那一环。
如果你手上已经有一块,或者正打算下单——先从 inbox → 本地 OCR/分类 → SQLite/FTS5 → 能被 Agent 调用 这个最小闭环跑起来,别一上来就想搭「全功能第二大脑」。把这一个 loop 跑通,你就有了一台真正属于自己的、不会在某次系统升级后变砖的(前提是别升 26.04)本地 AI 基建。
事实核对自:本机实测数据(16.6 / 13.0 tok/s、首 token 延迟、模型大小、GenieX 命令与配置)均来自我在 Arduino VENTUNO Q(主机名 ventunoq,Ubuntu 24.04.5,内核 6.8.0-qcom)上的实操记录;硬件规格与 299 美金预售价核对自 Arduino 官方产品页 与 官方商店(SKU ABX00181);Ubuntu 26.04 不兼容警告核对自 Arduino 官方论坛(2026-09-30~10-01,官方原话)。产品图为 Arduino 官方素材,仅作描述性引用。