早上九点,我刚坐下,钉钉弹出一张卡片:你上周在群里答应过的事,今天到期,台账里还没关闭。卡片下面给了下一步:一键催办责任人。我愣了一下——这个承诺,我自己已经忘了。
这样的早晨,过去几个月几乎天天发生。我一直在让数字员工接手我自己的工作流:每天读一千多条钉钉消息,编译事项台账,跟进我拍过的板、许过的诺(见从群聊到数字员工:AI 正在编译企业的影子工作系统)。以前这些靠我脑子记,漏掉的承诺就是漏掉的管理;现在台账替我记,到期它主动来提醒。
跑下来,体感分两层:第一眼,工作还是那个工作,变的只是每一步由谁来做;再往深看,有些步骤正在消失,也有些新步骤长了出来。把这份体感放大到企业视角,就是下面这篇分享。
开场:先换执行者,再改形状,最后改组织
先说一个结论,分三步:
AI 先替换工作流每一步的执行者,再重新定义哪些步骤还需要存在,最终和人一起重新组成组织。
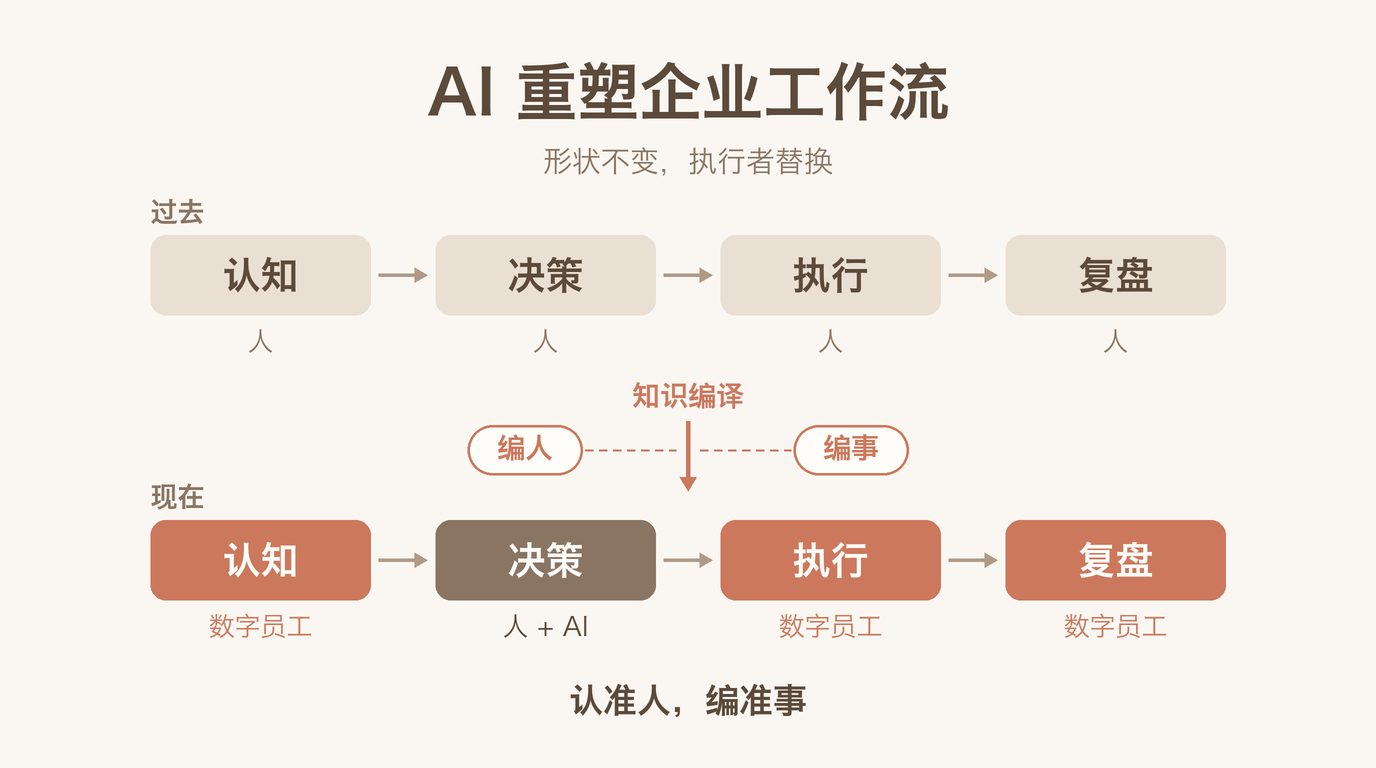
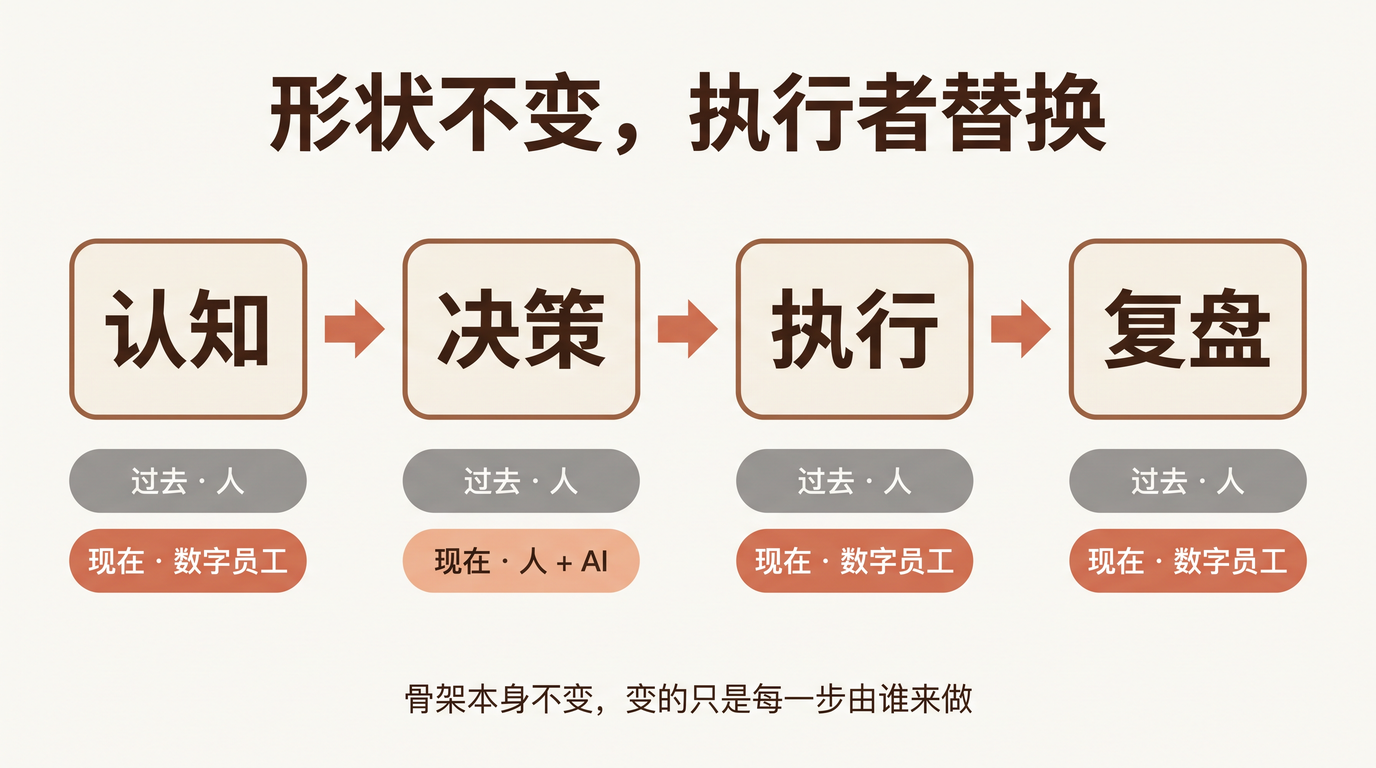
过去,一个完整的工作流程是认知、决策、执行、复盘。最先发生的变化是执行者:过去主要靠人,现在越来越多由数字员工来完成,人逐渐从具体执行中抽离出来,更多负责判断、决策和授权。
我最初把第一阶段的体感当成了终局,说过「AI 不会改变工作流的形状,只改变每一步由谁来做」。跑了几个月,我修正了自己:这只是入口阶段的真相。还是拿承诺跟进来说,以前是「群里看到、脑子记、周会逐项过问、事后复盘」;现在编译和提醒由数字员工持续完成,「脑子记」和「周会逐项过问」这两步直接消失了,复盘从每周一次变成随时发生。步骤不只是被替换,还会被删除和重排。
所以更准确的说法是:AI 先改变每一步由谁来做,再改变哪些步骤值得存在,最终改变组织本身。
认知、决策、执行、复盘这条骨架,在入口阶段保留它是策略——摩擦最小、最容易验收;但把它当成不可变的本质,会错过后面两步更大的红利。下面这张图,画的是第一步。
一、先看清中国企业的起点
我们首先要看清中国企业的现实。
过去几十年,中国企业的信息化、数字化发展很快,但很多企业并没有建立起一套完整、结构化、能够被 AI 直接使用的数据和知识基础。
很多管理实际上还是「因人成事」。
我一直有一个判断:
换一个人,事情就做不下去了,这不叫管理;换谁来做,都能按照同样的规则把事情做好,这才叫管理。
中国企业过去高速增长,很多时候靠的是人的能力、经验和灵活性,而不是标准化流程。
所以,直接照搬西方企业那套管理方法,或者一上来就用 AI 做高阶分析,并不现实。
底表不对,上层全是垃圾。
AI 再聪明,如果不知道企业有哪些人、谁负责什么项目、客户是谁、事情进展到哪一步,也不可能真正参与企业经营。
二、确定性的入口:中小企业老板
那么,谁最有动力推动这件事?
我的判断是:中小企业老板。
为什么?
老板每天想的其实很简单:同样的人,能不能做更多的事;同样的业务,能不能用更少的管理成本跑得更好。
一线员工不一定有动力主动改变自己的工作方式,但老板有。
因为老板算的是人力账,是经营账。
所以,我们看到的真实需求,并不是老板一上来就想做一个企业级 AI 平台,也不是想让 AI 帮他做多么高深的战略分析。
而是非常具体的事情:
能不能把公司的知识、客户信息、报价、设计稿、项目资料整理起来,让 AI 真正帮他干活?
这就是一个非常确定的商业入口。
先解决老板最关心的经营问题,再逐步把 AI 能力扩展到整个组织。
但动力不等于能力。销售不一定愿意把客户信息交出来,那是他的竞争优势;中层不一定愿意让 Agent 自动暴露项目延期,那会改变部门之间的权力关系。这不是模型问题,是组织激励问题。
所以数字员工不能只是挂在 IM 里的聊天机器人,它得像一个真正的组织成员:有岗位、有职责、有权限、有考核。老板买得下工具,买不下组织授权——这部分要设计,不能靠采购。
三、工作流重塑的关键:知识编译
那么,AI 怎么真正进入企业工作流?
中间有一个关键环节:知识编译。
过去是人去找数据、找文档、问同事。
未来是数据经过编译,主动成为 AI 可以理解、可以调用、可以执行的知识。
这中间最重要的是两件事。
第一,先编人。
企业有哪些人?谁在哪个项目?谁是负责人?谁参与决策?谁负责开发、销售、交付?
通讯录不是简单的一张名单,而是企业的组织关系、角色和责任体系。
人认不准,就找不到责任人;找不到责任人,事情就无法准确流转。「谁」为什么是编译器最难的一步,我在每天 1000 条钉钉消息,我让一个 Agent 先编译再开口里展开过。
第二,再编事。
企业每天发生大量事情,但不是所有聊天记录都值得成为知识。
我们需要把真正有价值的工作事项编译出来:谁负责、谁协作、优先级是什么、截止时间是什么、当前状态是什么。
特别重要的一点是:事项台账必须准。
已经完成的事情要关闭,已经失效的事情要淘汰,不能把企业知识库做成一个越来越臃肿的流水账。
不过,人和事只是第一层。我把编译对象分成三层:事实(谁、什么事、什么状态)、经验(为什么这样做、过去的成败案例)、能力(把事做好的方法、技能和策略)。先编事实是冷启动;只停在这一层,得到的只是一个更准的数据库;编到能力层,才有真正可执行的数字员工。
而且编译不是离线加工。Agent 每次执行产生的新事实、新经验、新方法,都要反过来写回企业上下文,学习闭环才成立。
那么,知识怎么编译?
这里有一个非常重要的工程方法:
不要把知识编译当成一个靠鼠标点点点的配置工作,而要把大模型作为整个知识编译的工作界面。
把数据导进去,直接通过对话让大模型工作。
你让它打标、分类、识别人、提取事项,也可以让它生成十道测试题。
你来判断对错,告诉它哪里错了,它再去调整编译方法、召回策略和排序规则。
我们的群编译器、通讯录编译器,就是沿着这个方向开发出来的。
还有一个很大的工程红利:
把规则变成 SPEC,而不是写死在代码里。
比如老板的消息权重更高,响应要更快;某个项目负责人发生变化,责任关系要及时更新。
这些规则都可以通过调整 SPEC 来实现,不必每次都修改代码、重新开发。
这意味着知识编译不是一次性的 ETL,而是一个可以持续迭代、持续学习的工程系统。
这套编译系统在工程上怎么分层、每层由谁写入、怎么保证一个月后还能溯源,我在知识编译最佳工程实践里写过完整方案;它为什么更像编译器而不是搜索框,见从程序编译器到企业上下文编译器。
四、真正的卡点不在模型,而在交付
讲到这里,我们会发现一个问题:
企业并不缺 AI 需求,真正缺的是能够把 AI 交付到业务现场的人。
我认为,未来 FDE 是一个非常重要的角色。
FDE 本质上就是过去的咨询顾问,但工作方式发生了变化。
过去咨询公司进企业,做调研、写报告、画蓝图,最后交给客户自己实施。
未来不一样。
现场咨询,现场编译,现场交付。
FDE 需要真正理解企业的业务,知道数据在哪里、权限怎么打通、知识怎么编译、工作流怎么重构,然后直接把数字员工交付出来。
| 传统咨询顾问 | FDE | |
|---|---|---|
| 工作方式 | 调研、写报告、画蓝图 | 现场咨询、现场编译、现场交付 |
| 交付物 | 方案,交给客户自己实施 | 直接交付数字员工 |
| 验收标准 | 报告与蓝图 | 业务真正跑通 |
这个角色的要求其实非常高。
我甚至认为,一个真正合格的 FDE,至少要有 P8 级别的综合能力,年薪百万都不一定能找到合适的人。
一个 P8 也未必能独立搞定。
所以,不要幻想通过一个通用平台,一次性解决所有企业的问题。
特别是企业权限、组织关系、历史数据的 mapping,一旦涉及复杂的业务系统,成本可能非常高。
我的建议是:
挑一到两个最有价值的业务场景,把它做深、做透,形成真正可以复制的标杆。
先交付结果,再沉淀平台能力。
不要反过来。
还要补一句:FDE 是阶段一,不是终态。如果每多一个客户就要多一个 P8,收入和交付成本还是近似线性增长——我们只是把软件定制开发,换成了 AI 定制开发。真正的规模化,是把 FDE 的交付经验本身也编译出来:调研、数据打通、知识编译、SPEC 生成、Evals 验收,逐步交给交付 Agent,人只留关键判断和验收。先让 FDE 把业务做透,再把 FDE 编译成 Agent。
这个顺序在经济上今天才算得过账。我在过去只有富人和大公司买得起的服务,正在变成默认配置里写过:AI 正在把定制化交付的成本打到极低。FDE 就是这个趋势在企业服务侧的形态——交付不再是一份报告,而是一个真正跑起来的数字员工。
五、成本必须算得清楚
还有一个问题,就是成本。
以事项台账编译为例,一天可能不到十万 Token。
但真正的大头,并不一定在首次编译,而是在知识编译之后持续运行的静默成本,以及后续的对话、总结、周报和主动推送。
特别是主动推送。
每一种主动推送都应该有自己的 SPEC。
什么时候推?推给谁?推什么内容?用户为什么需要现在看到它?希望用户采取什么下一步行动?
推送必须卡片化,突出与用户相关的信息,并且给出明确的下一步。
不能只是把系统里发现的所有信息都推给用户。
没有价值的主动推送,不是智能,而是骚扰;没有约束的 Agent,不是在创造价值,而是在消耗 Token。
比 Token 更贵的是错误执行。传统软件出错,多半是功能不可用;Agent 出错,可能是把错误报价发给客户、把过期规则当现行规则、把未经确认的判断当成事实、在没有授权的情况下改了业务数据。这些错误,多做几道知识检索测试是测不出来的。
所以数字员工上岗前,要有一套独立于知识编译的运行时治理:身份、权限、职责边界、审计、预算上限,以及分级审批——低风险自主执行,中风险执行前确认,高风险必须人批。知识编译解决 Agent 能不能理解企业,运行时治理解决它能不能可靠地在企业里干活。
成本的算法也要换。老板不算 Token,算结果。我会看三个数:一个有效业务结果的总成本(含人工审核和错误返工)、每个任务的人工介入率、每个数字员工创造的经营价值。每天 10 元 Token 但要人盯 30 分钟,不便宜;完成 100 个任务但 10 个没有价值甚至是错的,完成率再高也没意义。要追求的不是 Token 越来越便宜,而是每单位人工和算力,产出越来越多有效业务结果。
所以,企业 AI 必须把成本、效果和用户反馈放在同一个闭环里衡量。
六、给企业的三条务实建议
最后,如果今天要给企业老板三条建议,我认为是:
第一,先找一个人、一件事做透。
不要一上来铺十个场景,也不要一上来就建设一个庞大的企业 AI 平台。先找到一个真正有价值、能够衡量结果的场景。
第二,用智能编人和事,边编边用。
底表不是 AI 的前提,而是 AI 的产物:用大模型从乱数据里把组织关系、责任人、业务事项编出来,边编边校准。底表不准,模型再强也没有用;但等底表「准了」再上 AI,就永远上不了。
第三,把交付能力写进合同。
买 AI 不只是买模型、买软件、买 Token。要明确供应商有没有 FDE,能不能深入现场,能不能真正把业务跑通,最终交付数字员工。
否则,买回来的可能只是一份漂亮的 PPT。
结尾:认准人,编准事,然后重新发明组织
最后,我想说:
知识编译会成为未来企业的基础设施。
谁真正掌握了企业的业务知识,谁就有机会成为企业未来的 AI 咨询师、战略师,甚至成为企业经营的一部分。
今天,基建和工具正在快速成熟,模型能力也在不断进步。
但真正难的,不是把工具搭起来,而是理解业务、做好顶层设计,知道企业应该先做什么、后做什么。
所以,我们先把一件事情做准:
认准人,编准事。
让 AI 真正理解企业,让数字员工真正进入工作流。
这才是 AI 重塑企业工作流的起点。但起点不是终点,往远看,我认为会发生三件事。
工作流会被重新设计。当执行成本足够低,先敢删步骤、合并步骤的企业会拿到红利。流程不是用来照搬数字化的,是用来重新设计的。
组织单元会变。部门之外,会出现「一个负责人 + 一组数字员工」的人机混合团队:企业上下文是共同认知,Harness 是数字员工的运行和治理环境。企业第一次有机会按数字员工的生产力重新设计组织,而不是在旧组织上贴 AI。
核心资产会变。未来真正有竞争力的企业,不是拥有最多 AI 工具的企业,而是能持续把自身业务能力编译成数字员工、并让它们持续产出业务结果的企业。
过去,企业通过组织人、设计流程、建设软件来创造生产力;AI 时代,企业要把自己的业务知识和工作能力编译出来,让数字员工成为组织的生产力。AI 不只是替代人的工作,而是让企业第一次有机会重新设计自己的工作流、组织结构和生产方式。
所以这篇分享是一个三步的起点:先换执行者,再重构工作流,最后重构组织。认准人,编准事,是第一步;真正的终点,是企业重新发明自己。
你的企业里,哪一步工作流已经换过执行者?有没有哪一步,已经直接消失了?卡住你的是底表不准、没人交付,还是组织没授权?欢迎留言聊聊。